GPT-5.4 Mini und Nano: Die neuen Könige der Small Models
GPT-5.4 Mini erreicht 60 % auf Terminal-Bench 2.0 für nur $0.75/1M Input. GPT-5.4 Nano kostet $0.20/1M. Beide sind jetzt auf Smart AIPI mit 75 % Rabatt verfügbar — so nutzt du sie für Agents, Coding und Computer Use.
TL;DR: GPT-5.4 Mini und Nano sind live auf Smart AIPI. Mini erreicht 60 % auf Terminal-Bench 2.0 bei $0.75/1M Input. Nano kostet nur $0.20/1M. Beide sind mit 75 % Rabatt verfügbar. Verwende gpt-5.4-mini und gpt-5.4-nano in jedem API-Aufruf.
OpenAI hat gerade zwei neue Modelle der 5.4-Familie veröffentlicht, und sie verändern die Wirtschaftlichkeit der AI-Entwicklung. GPT-5.4 Mini liefert Coding-Fähigkeiten nahe dem Frontier-Niveau zu einem Bruchteil des Preises. GPT-5.4 Nano ist das günstigste Frontier-Modell, das je veröffentlicht wurde.
Beide sind jetzt auf Smart AIPI live.
Die Zahlen
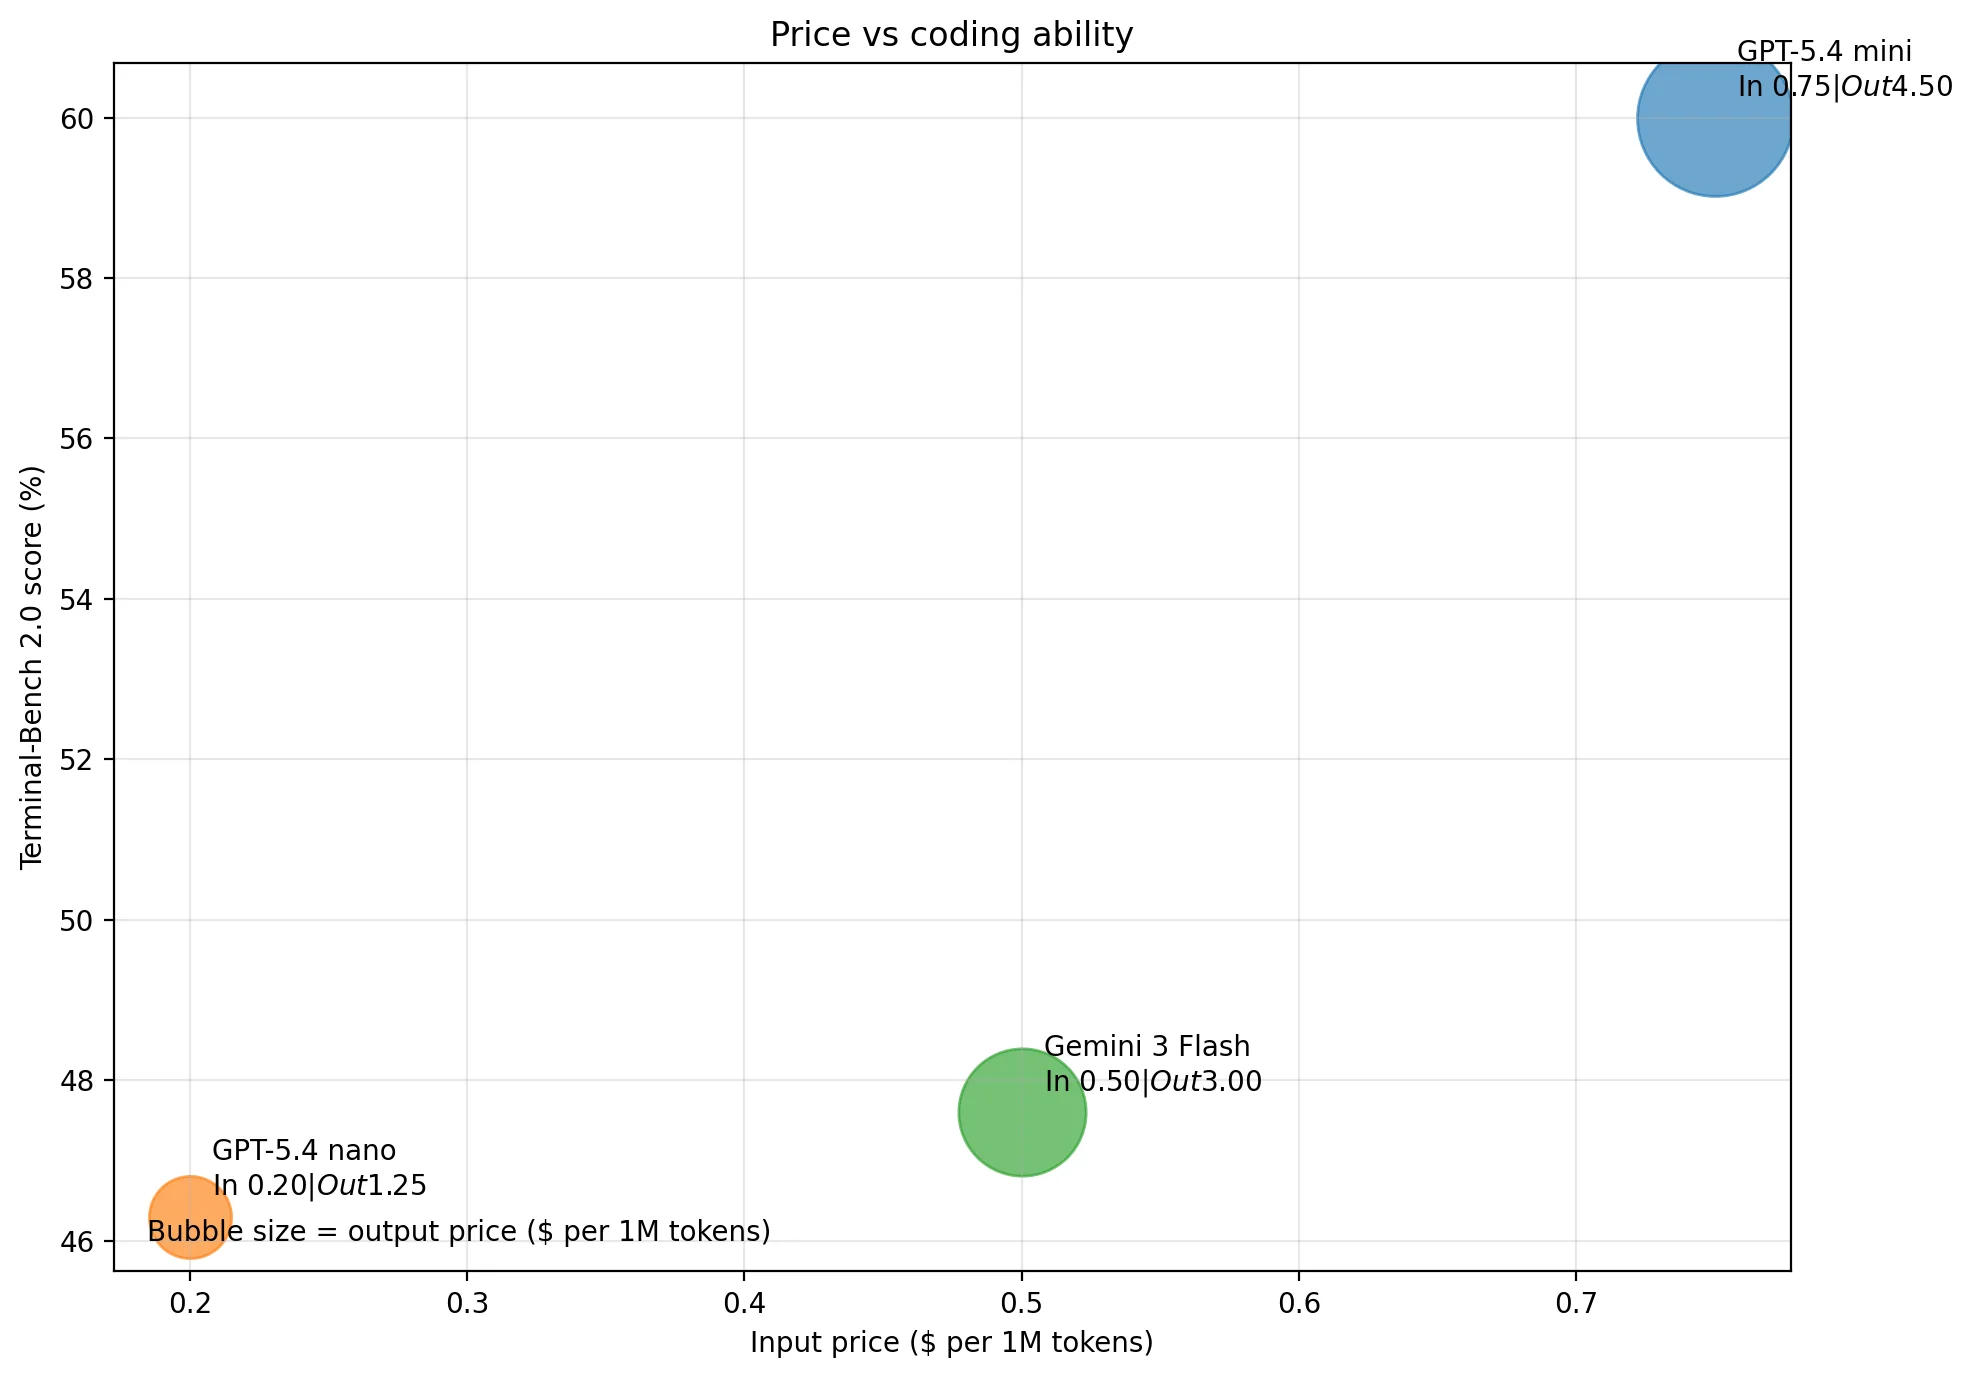
So schneiden die neuen Modelle bei Preis und Leistung im Vergleich ab:
| Modell | Terminal-Bench 2.0 | Input /1M | Output /1M | Smart AIPI Output |
|---|---|---|---|---|
| GPT-5.4 Mini | 60.0% | $0.75 | $4.50 | $1.125 |
| GPT-5.4 Nano | 46.2% | $0.20 | $1.25 | $0.3125 |
| Gemini 3 Flash | 47.7% | $0.50 | $3.00 | N/A |
| GPT-5.4 (voll) | 72.1% | $2.50 | $15.00 | $3.75 |
GPT-5.4 Mini schlägt Gemini 3 Flash beim Coding um mehr als 12 Punkte, während es beim Input nur 50 % mehr kostet. Und auf Smart AIPI wird diese Lücke noch kleiner — du zahlst $0.1875/1M Input statt $0.50 bei Gemini.
Wann welches Modell verwenden
Die 5.4-Familie bietet dir jetzt drei Stufen, passend zu deinem Workload:
GPT-5.4 Mini: Das Arbeitspferd für Subagents
Das ist das Modell, das du für parallelisierte Coding-Tasks willst. Wenn du Codex, Claude Code oder ein anderes agentisches Coding-Tool nutzt, das Subagents startet, ist Mini der Sweet Spot.
Der Kostenhebel bei Subagents:
- Betreibe deinen Haupt-Agent auf
gpt-5.4mit hohem Reasoning für Architekturentscheidungen - Starte Subagents auf
gpt-5.4-minimit hohem Reasoning für Implementierungsaufgaben - Jeder Subagent kostet ~70 % weniger als auf dem vollen Modell, erreicht aber trotzdem 60 % auf Terminal-Bench
- 10 parallele Subagents auf Mini kosten weniger als 3 auf GPT-5.4 — und sind schneller fertig
Mini ist außerdem stark bei Computer Use und Browser-Automatisierung. Es liefert solide Genauigkeit bei UI-Interaktionsaufgaben bei deutlich höherer Geschwindigkeit als GPT-5.4 und ist damit die richtige Wahl für Web-Scraping-Agents, automatisierte Tests und jeden Workflow, in dem das Modell durch Bildschirme navigieren und Buttons anklicken soll, ohne dein Budget zu verbrennen.
Codex CLI-Tipp: Setze model = "gpt-5.4-mini" in ~/.codex/config.toml zusammen mit model_reasoning_effort = "high" für einen schnellen, leistungsfähigen Coding-Assistenten, der deine Credits nicht leerzieht.
GPT-5.4 Nano: Das Arbeitspferd für den Alltag
Für $0.20/1M Input (oder $0.05 auf Smart AIPI) ist Nano praktisch kostenlos. Es ist kein Coding-Modell — aber das muss es auch nicht sein. Nutze es für alles andere:
- Klassifizierung und Routing — entscheiden, welches Modell oder Tool aufgerufen werden soll
- Zusammenfassung — Dokumente, Gespräche und Suchergebnisse verdichten
- Datenextraktion — strukturierte Felder aus unstrukturiertem Text ziehen
- Einfache agentische Aufgaben — simple mehrstufige Workflows ohne Code-Generierung
- Gesprächstitel — wir nutzen es selbst zum Generieren von Chat-Titeln
- Content-Moderation — schnelles, günstiges Content-Filtering in großem Maßstab
Nano übernimmt Aufgaben, für die zuvor GPT-4.1 Mini oder GPT-5 Mini nötig waren, aber zu einem Bruchteil der Kosten. Für High-Throughput-Pipelines mit Millionen von Requests sind die Einsparungen enorm.
Hinweis: GPT-5.4 Nano unterstützt derzeit nur den Chat Completions endpoint (/v1/chat/completions). Die Responses API ist für dieses Modell noch nicht verfügbar. Wenn du Tools wie Codex CLI verwendest, die den Responses endpoint benötigen, nutze stattdessen Mini.
Der Smart Model Stack
Dieses Muster empfehlen wir für produktive AI-Anwendungen:
| Aufgabe | Modell | Warum |
|---|---|---|
| Architektur, komplexes Reasoning | gpt-5.4 | Best-in-Class-Qualität für kritische Entscheidungen |
| Coding-Subagents, Code-Review, Computer Use | gpt-5.4-mini | 60 % Terminal-Bench bei 70 % geringeren Kosten als 5.4 |
| Routing, Klassifizierung, Zusammenfassungen, Extraktion | gpt-5.4-nano | Nahezu kostenlos bei $0.05/1M Input auf Smart AIPI |
| Bildgenerierung und -bearbeitung | gpt-image-1.5 | Frontier-Bildqualität |
| Videogenerierung | sora-2 | Bis zu 20 s Video aus Text oder Bild |
Schnellstart
Beide Modelle funktionieren mit jedem OpenAI SDK. Setze einfach die Model-ID:
Preise auf Smart AIPI
Wie immer 75 % unter den direkten Preisen von OpenAI:
| Modell | Input /1M | Cached Input /1M | Output /1M |
|---|---|---|---|
| GPT-5.4 Mini | $0.1875 | $0.01875 | $1.125 |
| GPT-5.4 Nano | $0.05 | $0.005 | $0.3125 |
Mit prompt caching (automatisch, ohne Setup) sehen langlaufende Agents mit konsistenten System-prompts Cache-Hit-Raten von 30–50 % — das macht Mini für agentische Workloads noch günstiger.
Jetzt loslegen
Beide Modelle sind sofort verfügbar. Keine Warteliste, kein spezieller Zugang nötig.
- Registriere dich für ein kostenloses Smart AIPI-Konto (inklusive $5 gratis Credits)
- Setze deine base URL auf
https://api.smartaipi.com/v1 - Verwende das Modell
gpt-5.4-miniodergpt-5.4-nano - Oder probiere sie sofort aus auf chat.smartaipi.com
Die Ära teurer AI ist vorbei. Baue mehr, gib weniger aus.
OpenAI-kompatibles API-Gateway. Greife auf Frontier-AI-Modelle zu 75% geringeren Kosten zu.
Kostenlos starten